一、真实场景:当代码托管在新加坡,工程师却坐在北京
凌晨两点,某跨境电商企业的后端工程师老王正通过 VS Code Remote-SSH 连接部署在境外的开发服务器,准备把手头这个用 Claude 编程助手辅助重构的模块跑一遍单元测试。屏幕忽然卡住——连接掉了。重新连上,敲了两行代码又断了一次。与此同时,隔壁工位的同事在调用官方大模型 API 时收到一串陌生的错误码:403 Forbidden。没有人做错什么,问题出在两者都没太在意的地方:网络链路本身。
这是宝商AI在过去两年为多个全球分布式研发团队提供 MSP(管理服务提供商)托管运维服务时,反复遇到的开局问题。团队的算力、代码库、协作工具分布在不同大洲,工程师的物理位置和服务器的物理位置之间,隔着一整段说长不长、说短也绝不短的公网链路——而绝大多数团队第一次为此吃亏,往往是在项目已经上线之后。
架构师洞察:
跨境软件工程团队在配置面向全球顶尖技术栈的研发环境时,核心瓶颈通常不在于算力本身,而在于「出站网络的洁净度」与「入站链路的稳定性」——这两个变量决定了工程师的日常体验,也决定了大模型调用能否稳定送达。
二、拆解问题:两类网络硬伤,一套系统性解法
1. 入站侧:跨境 Remote-SSH 为什么总在关键时刻掉线
国内研发终端通过 VS Code Remote-SSH 直连境外服务器时,因跨境网络路径中的多个中转节点存在带宽瓶颈,常出现毫秒级抖动、Connection reset 甚至 TCP 超时断开。对沉浸式编码体验而言,这种断连不是"偶尔不便",而是实实在在拖慢交付节奏的隐形成本。
2. 出站侧:为什么"没做错事"的请求也会被拦
大量公有云的通用 IP 地址段,由于历史上曾被滥用或托管过高频爬虫、攻击流量,在主流大模型服务商的边缘防护体系(如 Cloudflare)中信誉分并不理想。研发服务器从这类地址段发起的正常出站请求,有时会被通用风控策略连带误判,抛出 403 Forbidden 或 1020 等阻断响应——这与"是否合规使用"无关,纯粹是基础设施选址与 IP 信誉度的问题,却足以让工程团队排查半天摸不着头绪。
三、宝商方法论:从选址到内核参数的全链路工程重构
面对这类问题,宝商AI的解法不是"打补丁式"地临时更换节点,而是把网络底座当作一项独立的工程交付物来规划——从节点选址、算力配置、系统镜像,到 DNS 解析层与 TCP 协议栈参数,形成一套可复制、可验收的标准化方案。
1. 灰度节点选址:为什么是新加坡与东京
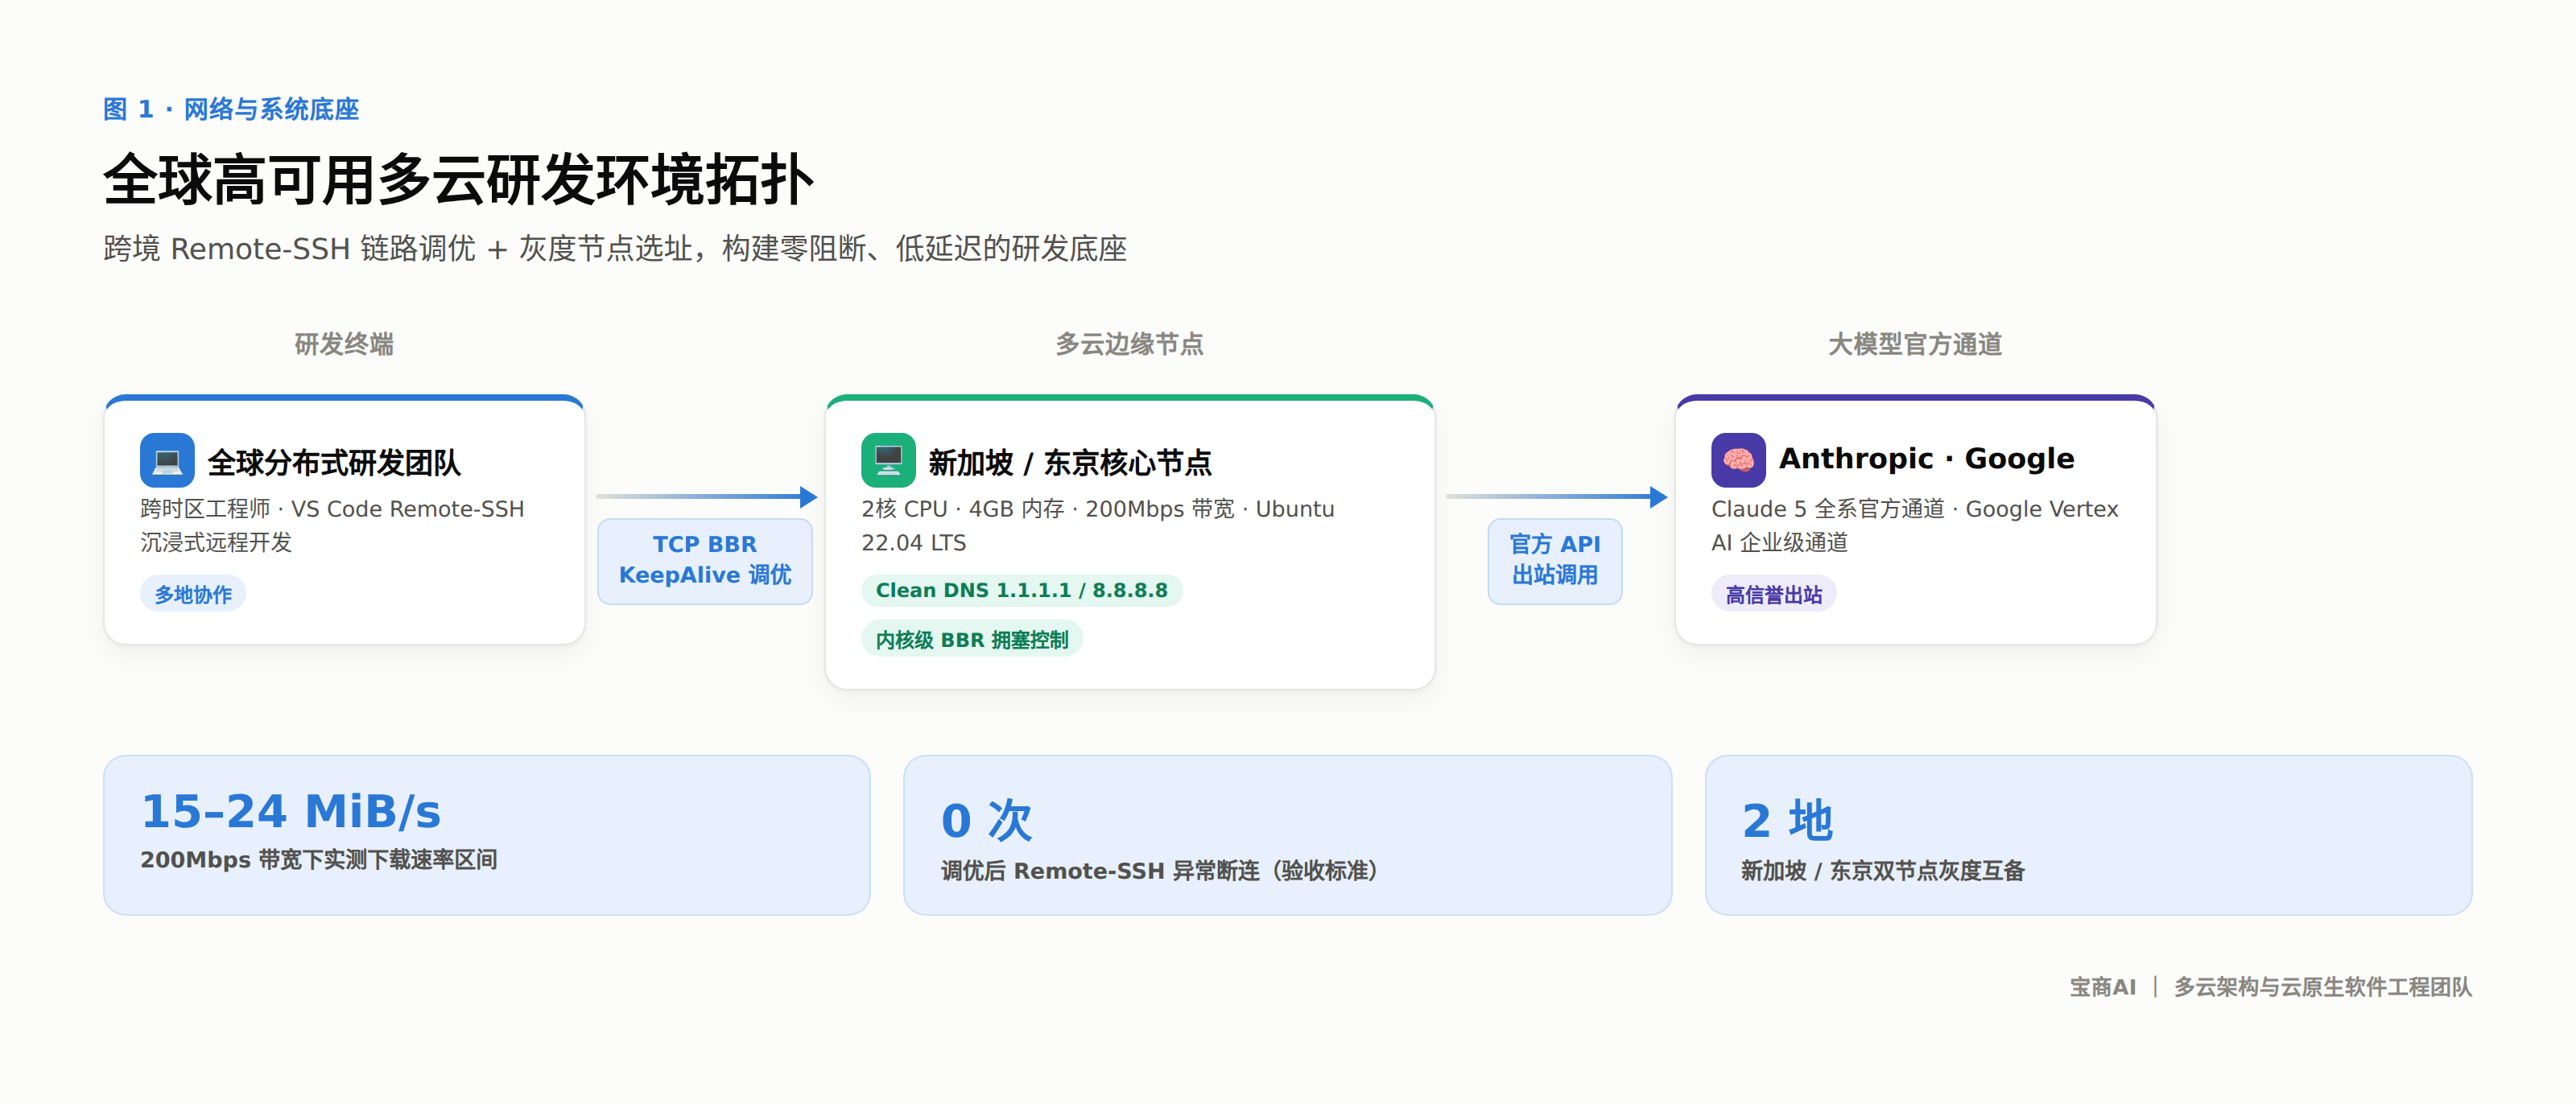
多云多中心选址:优先选择新加坡(东盟中立数据枢纽,具备优异的全球网络互通性)或日本东京作为亚太核心中继节点,两地互为灰度备份,任一节点出现区域性拥塞时可平滑切换。
算力资源基准:采用轻量化高带宽配置(典型基准:2 核 CPU / 4GB 内存 / 60GB SSD 系统盘 / 200Mbps 峰值带宽),在成本与吞吐之间取得工程上的最优平衡。
基础设施镜像:标准化采用 Ubuntu 22.04 LTS(x86_64),确保与主流容器化技术栈及现代开发工具链保持绝对兼容,避免"环境漂移"带来的排障成本。
四、核心技术实施:从 DNS 到内核参数的精细化调优
1. 智能出站选路:重构 Clean DNS 解析层
传统机房默认 DNS 常存在解析劫持、解析漂移等问题,间接放大风控误判概率。我们的第一步,是重构服务器的出站解析层,统一切换至全球高信誉度的公共解析服务:
# 编辑 /etc/resolv.conf,强制使用高信誉度 Clean DNS
nameserver 1.1.1.1
nameserver 8.8.8.8
2. 内核级链路重构:TCP BBR 与 KeepAlive 调优
针对跨境远程开发连接易超时的硬伤,我们在服务器内核层面废弃传统 Reno/Cubic 拥塞控制算法,启用 Google 开源的 BBR 算法,并重新配置 TCP 保活参数,从根本上降低网络波动对终端体验的影响:
# 1. 注入内核 BBR 与队列管理算法参数
echo "net.core.default_qdisc=fq" | sudo tee -a /etc/sysctl.conf
echo "net.ipv4.tcp_congestion_control=bbr" | sudo tee -a /etc/sysctl.conf

# 2. 优化 TCP KeepAlive,防止跨境链路静默切断空闲连接
echo "net.ipv4.tcp_keepalive_time = 60" | sudo tee -a /etc/sysctl.conf
echo "net.ipv4.tcp_keepalive_intvl = 10" | sudo tee -a /etc/sysctl.conf
echo "net.ipv4.tcp_keepalive_probes = 6" | sudo tee -a /etc/sysctl.conf

# 3. 重载内核参数并验证 BBR 已生效
sudo sysctl -p
lsmod | grep bbr
五、工程化验收:宝商如何定义"调优完成"
技术调优如果没有可量化的验收标准,就只是"感觉变快了"。我们为每一次网络底座交付设定明确的验收基线:完成调优后,在服务器端拉取大型开源项目进行实测,200Mbps 峰值带宽下载速率应稳定在 15–24 MiB/s 区间;同时对官方大模型 API 发起出站探测调用,确认状态码持续正常、无 403/1020 类误拦截——两项指标同时达标,才视为网络底座调优完毕、可交付业务团队使用。
结语:网络底座,是多云治理的第一块基石
很多企业在评估"要不要上大模型驱动研发"时,容易把注意力全部放在模型能力和产品功能上,却忽略了承载这一切的网络底座。宝商AI在为全球分布式团队提供 MSP 托管运维的过程中始终坚持:治理不是选出"最好的"云或模型,而是用工程化的方法,让每一层基础设施都稳定、可控、可验收——这也是我们"技术中立、甄选最优架构"理念在最底层的落地。
在系列第二期中,我们将把视角从"网络地基"上移一层,拆解宝商AI如何基于 LiteLLM 与 OpenWebUI,为企业构建统一的多云大模型网关,用"双轨道"协同工作流与美元级硬预算熔断机制,守住企业的模型资产安全。敬请期待。